
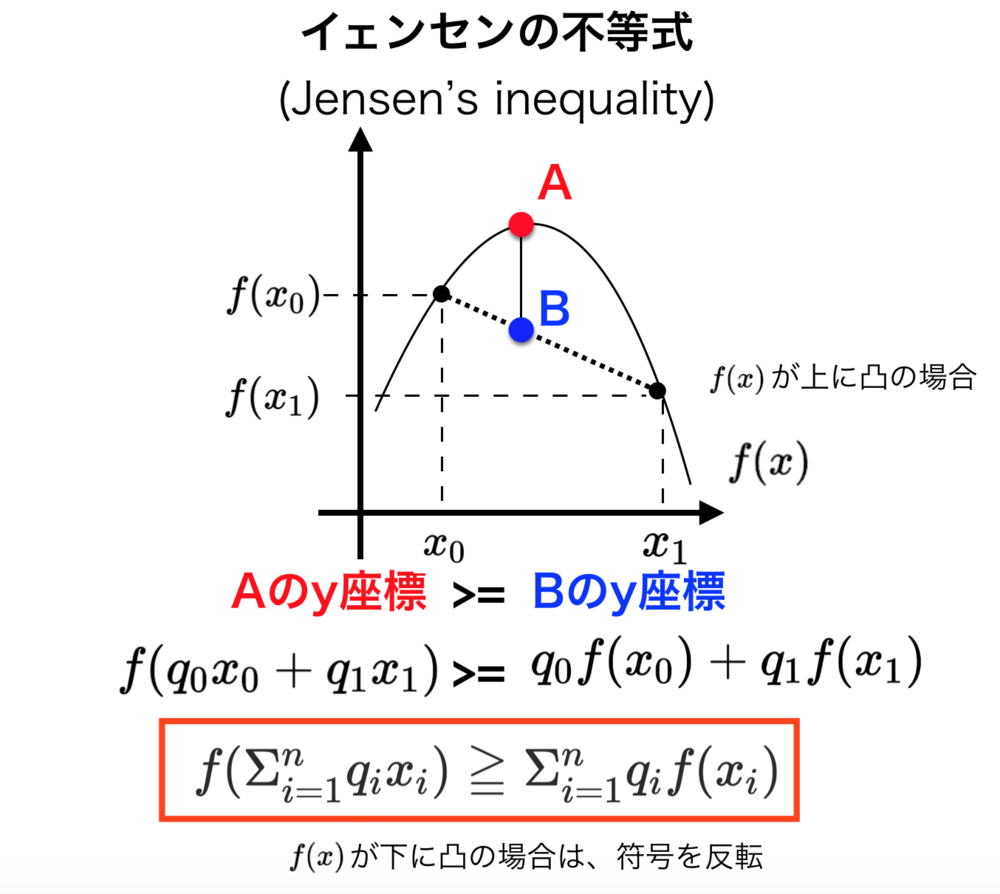
イェンゼンの不等式とは?Aiと統計学を支える超重要定理を徹底解説
イェンゼンの不等式に関して、学習者が陥りがちな最大の誤解が「不等式で得られた下界(ELBO)は、常に真の対数尤度に近い」という思い込みです。
実際には、イェンゼンの不等式にはイェンゼン・ギャップ(Jensen Gap)と呼ばれる誤差の開きが存在します。
$$\text{Gap} = \mathbb{E}[f(X)] - f(\mathbb{E}[X]) \approx \frac{1}{2} f''(\mathbb{E}[X]) \mathrm{Var}(X)$$
テイラー展開による近似式が示す通り、確率変数 $X$ の分散(ばらつき)が大きいほど、イェンゼンの不等式が与える下界と真の値との乖離は拡大します。
このギャップが広がりすぎると、どれだけELBOを最適化しても、真のデータ生成分布を全く捉えられないという性能限界に直面します。この構造的弱点を克服するために考案されたのが、重点サンプリングを導入したIWAE(Importance Weighted Autoencoders)や、複雑な変換を重ねる正規化流(Normalizing Flows)などの発展モデルです。
【プロの結論】初学者が押さえるべき学習ステップと使い分けの判断基準
イェンゼンの不等式を道具として使いこなすための判断基準を整理しました。
- 実務・エンジニア志向の方:厳密な測度論的証明に時間を費やすよりも、「$\log$ の外側にある期待値を内側に入れると値が小さくなる(下界ができる)」というパターン認識を徹底し、ELBO導出の流れを紙とペンで再現できるレベルを目指すべきです。
- 研究開発・理論志向の方:等号成立条件(分散が0、すなわち確率変数 $X$ が定数であること)および、イェンゼン・ギャップがモデル表現力に与える影響の定量評価まで踏み込むことが不可欠です。



