アプリ不要!手書き漢字検索の裏ワザと2026年最新ツールの完全攻略
手書き漢字検索を利用する際、ネット上でまことしやかに囁かれている誤解や、検索失敗を引き起こす盲点が存在します。これらを正しく認識しておくことが、無駄な試行錯誤を減らす鍵となります。
誤解1:「書き順(筆順)が間違っていると認識されない」という神話
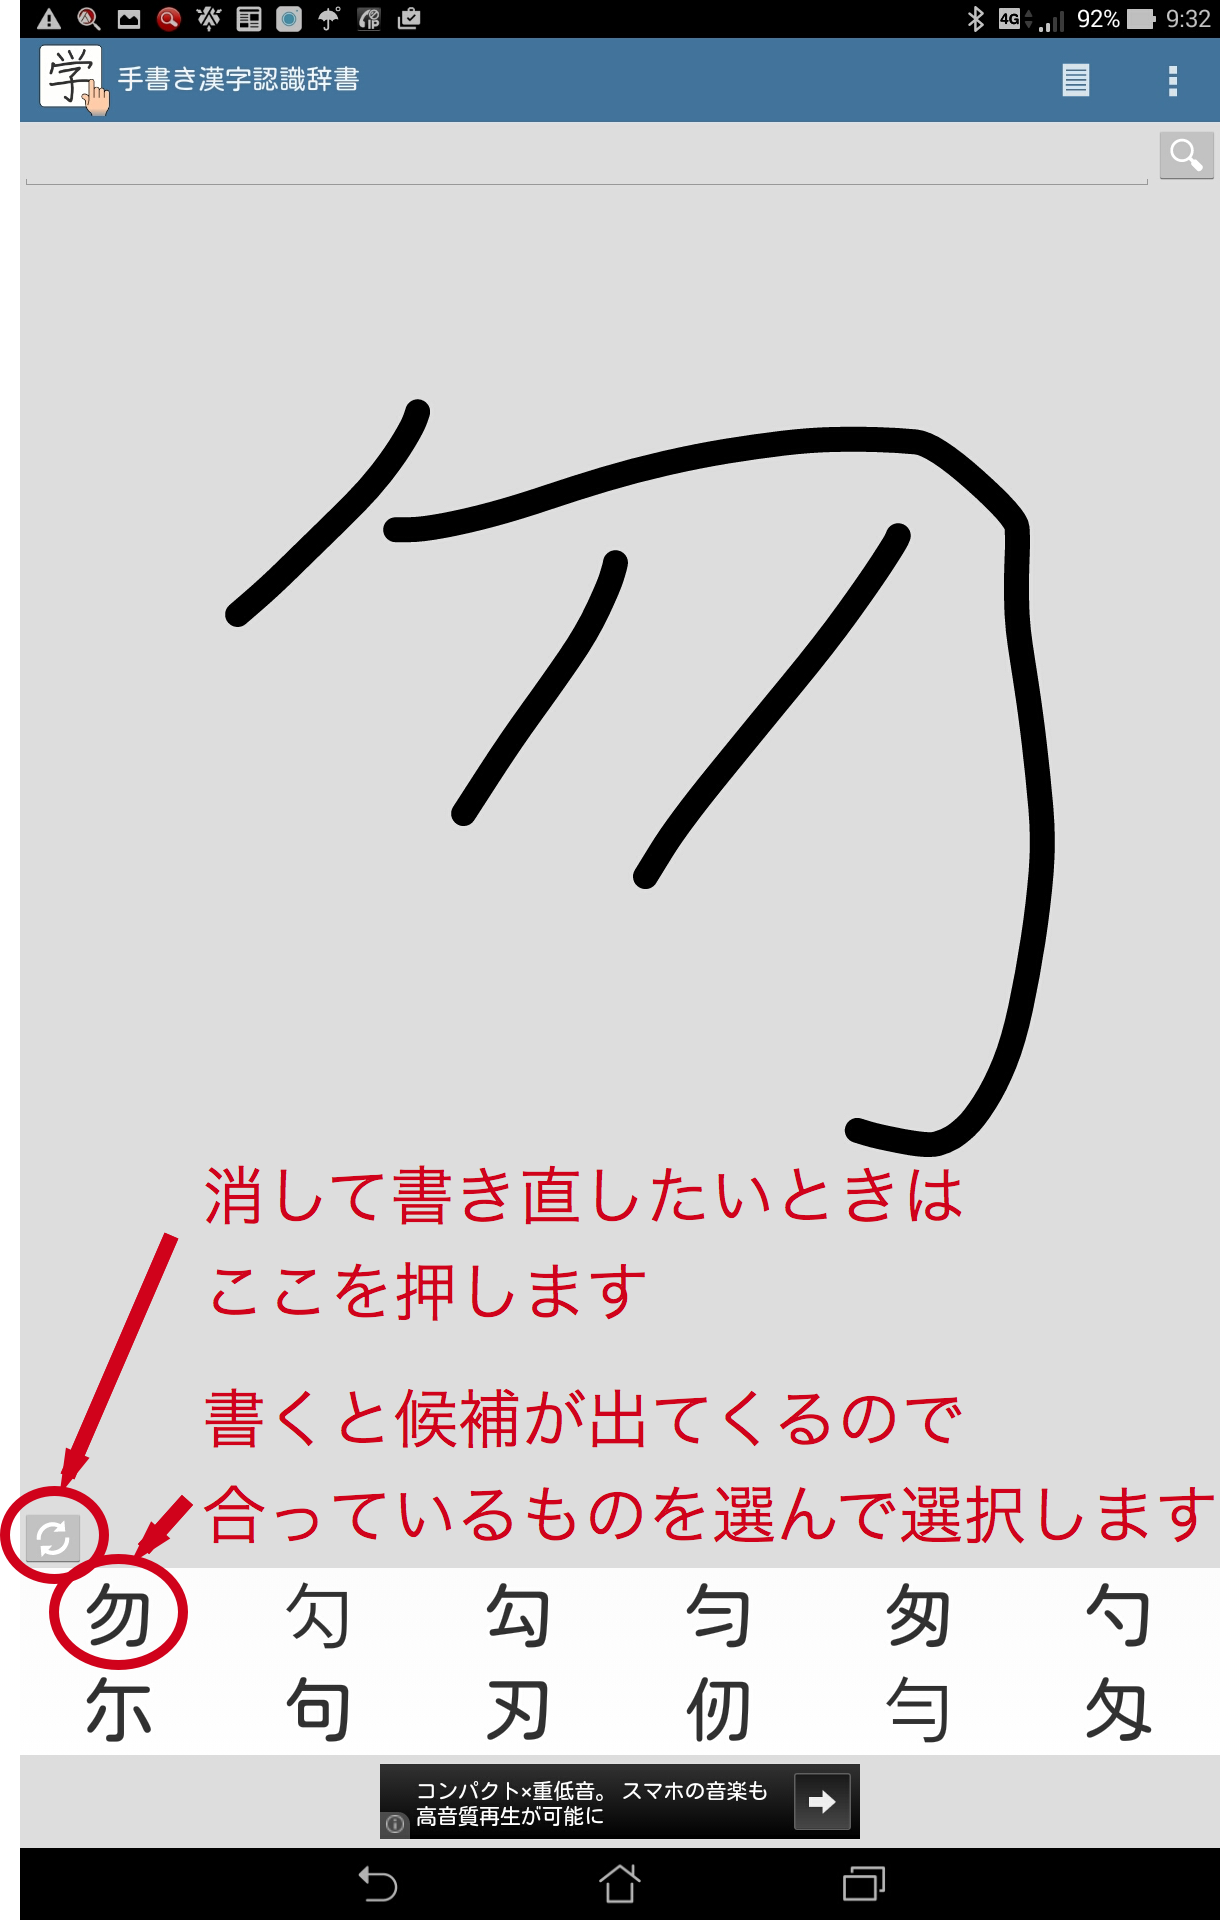
旧来の電子辞書や初期の携帯電話では、ストロークの順序(書き順)を厳密に照合していたため、筆順を間違えると全く別の漢字が候補に出てくるケースが多発していました。しかし、2026年最新漢字検索ツールの多くは、筆順のトポロジー(幾何学的接続関係)や輪郭形状を解析する画像認識・ベクトル照合型AIへと進化しています。書き順が多少違っていようと、全体の字形さえ概ね整っていれば、極めて高い精度で正しい漢字がトップ候補に提示されます。
誤解2:旧字体・異体字は手書きでは出ないという思い込み
人名や地名に使われる「渡邉」の「邉」や「齋藤」の「齋」など、複雑な異体字は手書き検索に向いていないと思われがちです。しかし、実際には難読漢字検索ツールのデータベースはJIS第3・第4水準やUnicodeのCJK統合漢字を網羅しています。パーツのバランスが多少崩れても、特徴的なハネやハライを再現して枠内に大きく描くことで、確実に拾い上げることが可能です。
誤解3:部首検索の方が確実であるという先入観
学校教育の刷り込みにより、「漢字は部首から引くのが最も確実」と信じ込んでいる人は少なくありません。しかし、「凹」「凸」「承」「乗」のように部首の特定が極めて難しい漢字や、冠(かんむり)と旁(つくり)の境界が曖昧な漢字では、部首判定を誤った瞬間に永遠に答えへ辿り着けなくなります。直感的に形をそのまま模倣できる手書き検索こそが、認知的な負荷を最小限に抑える最強の手段です。