
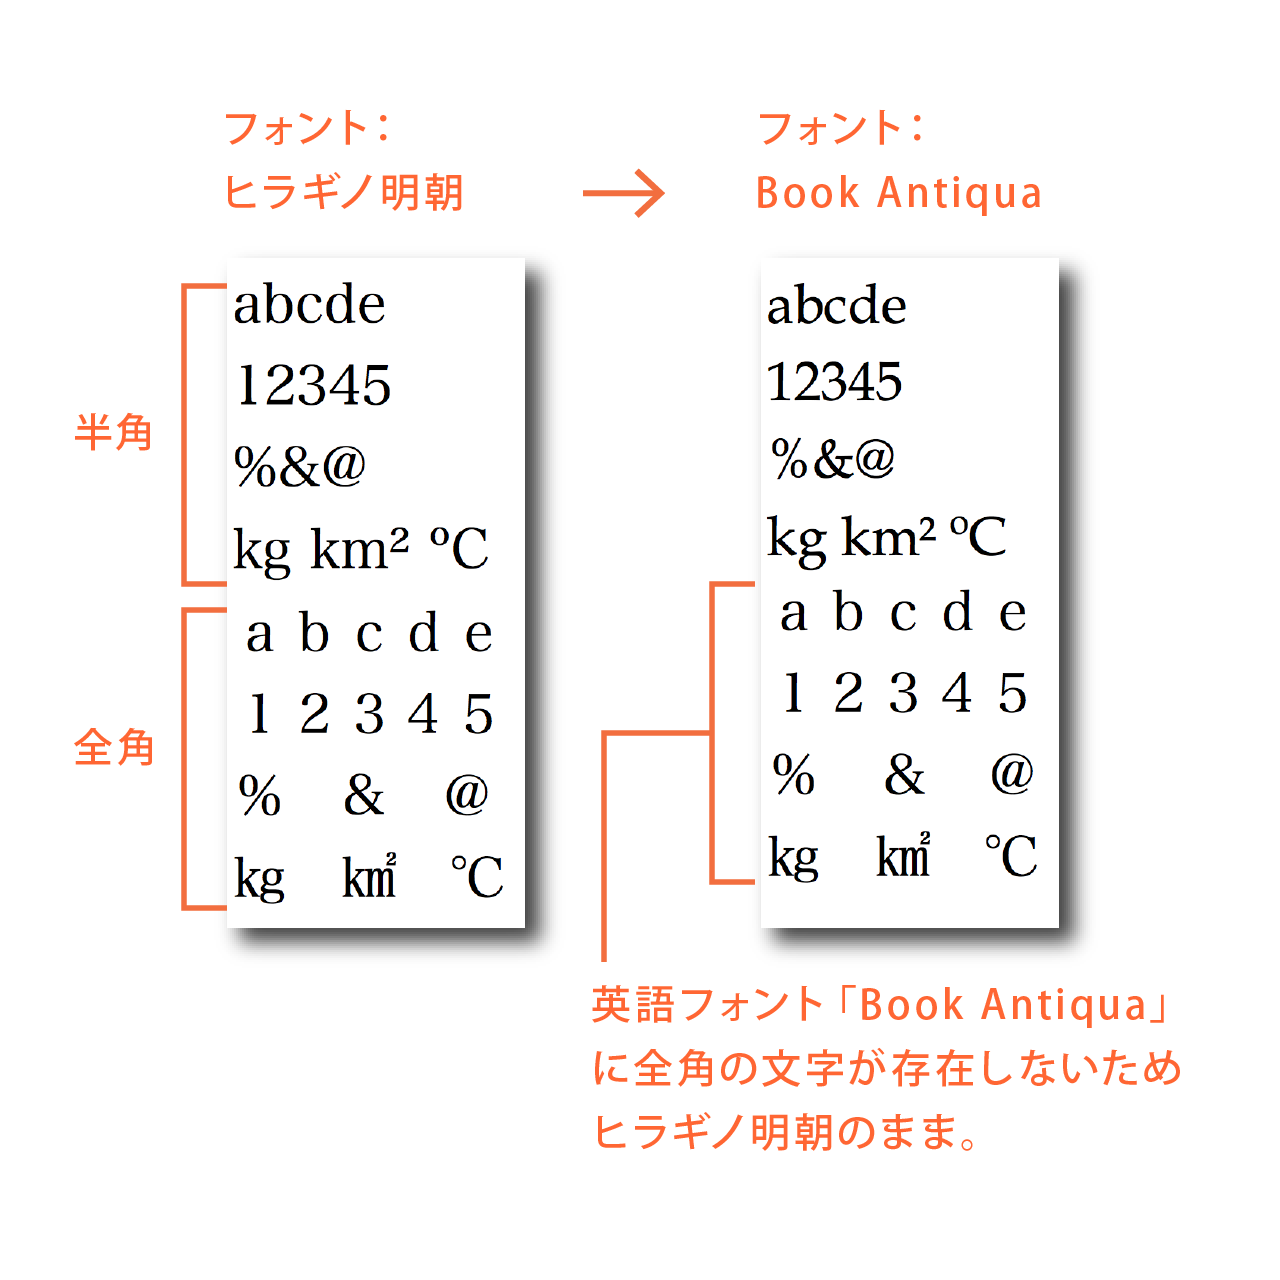
全角文字とは何か?半角との違いとエラーが起きる3つの真相を徹底解説
そもそも全角文字とは、文字の横幅と縦幅の比率が「1対1」の正方形に収まるように設計された文字のことを指します。この名称は、活版印刷の現場で正方形の活字ボディ(全角=em)と呼ばれていたことに由来します。これに対し、横幅が全角の半分(比率1対0.5)で作られた文字を「半角(en)」と呼び、これが基本的な全角半角違いの原点です。
コンピュータの歴史において、この違いは極めて切実なデータ容量の問題に直結していました。英語圏で誕生した初期のコンピュータは、アルファベットや数字、基本的な記号など約128種類の文字を表現できれば十分だったため、1文字を7〜8ビット(=1バイト)で管理する仕組みを採用しました。これが全角半角バイト数仕組みの基礎となる半角英数です。
しかし、数千文字にも及ぶ漢字、ひらがな、カタカナを扱う日本語環境では、わずか256通りしか表現できない1バイトでは到底足りません。そこで1970年代から80年代にかけて策定されたのが、2バイト(16ビット=約6万5千通り)を使って日本語を表現するJIS規格(JIS X 0208など)でした。コンピュータ業界の歴史的経緯において「全角=日本語を扱うための2バイト文字」「半角=英数を扱うための1バイト文字」という図式が定着したのです。
現代のインターネットで標準となった2バイト文字Unicode詳細まとめの視点から補足すると、現在は世界中の文字を単一の体系で扱う「UTF-8」が主流です。UTF-8の世界では、英数は1バイトですが、全角のひらがな・カタカナ・漢字は通常「3バイト(一部は4バイト)」で処理されます。つまり、2026年現在の内部処理においては「全角=2バイト」という定義は技術的には過去のものとなりつつありますが、文字幅のレイアウト概念や旧規格の互換性として「全角」という用語が生き続けています。



